KI liest Lohnausweise: Warum Testdaten wichtiger sind als das Modell

Thumbnail
Ein Lohnausweis, eine Krankenkassenbescheinigung oder ein Depotauszug ist für dich als Mensch meist auf den ersten Blick verständlich. Du siehst die Tabelle, findest die Zahl, ordnest sie ein - fertig. Für ein KI-System ist genau das eine der schwierigsten Aufgaben überhaupt. Es muss das Dokument lesen, richtig einordnen und die relevanten Angaben den passenden Feldern zuweisen, ohne dass jemand daneben sitzt und mitdenkt.
Dieser Prozess trägt einen eigenen Namen: Dokumentenextraktion. Dabei werden unstrukturierte Dokumente in strukturierte Daten verwandelt - etwa der Bruttolohn aus einem Lohnausweis oder der Rückkaufswert aus einer Versicherungsbescheinigung. Klingt simpel, ist es aber nicht. Die eigentliche Herausforderung liegt nämlich nicht darin, ein einzelnes Dokument korrekt zu verarbeiten. Spannend wird es erst bei der Frage, ob ein System auch mit völlig unterschiedlichen Formularen, wechselnden Scanqualitäten und kniffligen Sonderfällen zuverlässig klarkommt. Genau hier entscheidet sich, ob eine KI-Lösung im Alltag wirklich taugt oder nur in der Theorie glänzt.
Warum wenige Testdokumente nicht ausreichen
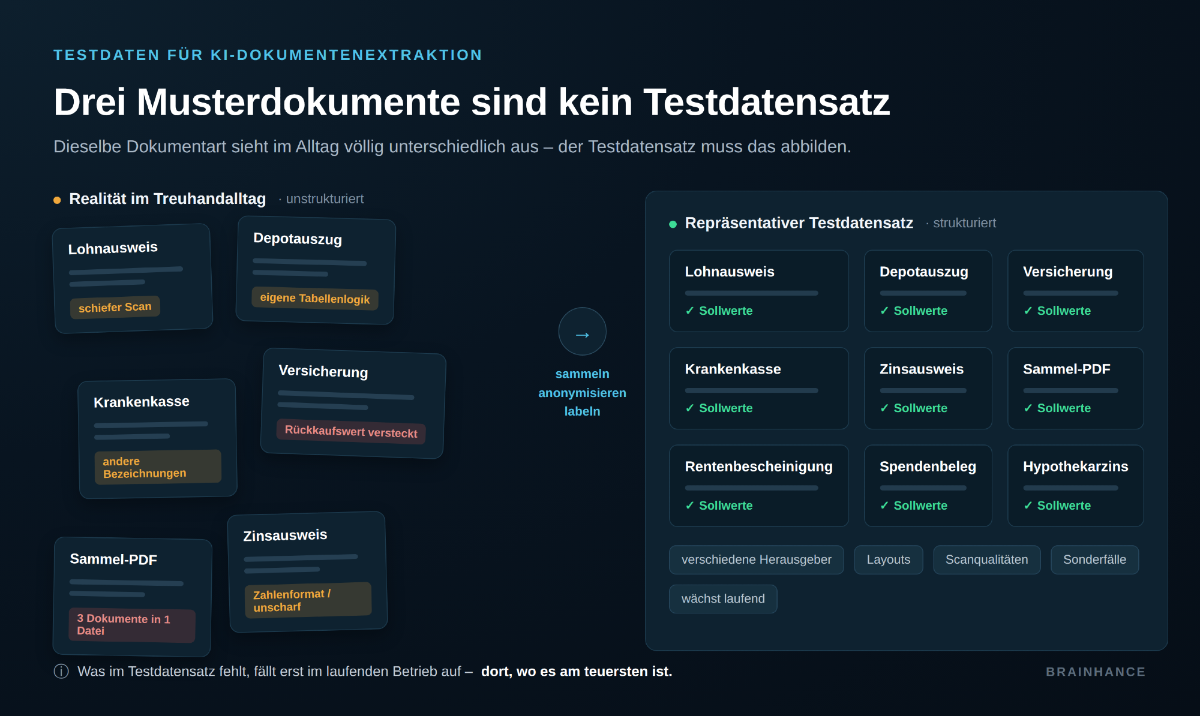
Dokumente derselben Kategorie sehen oft überraschend unterschiedlich aus. Versicherungen nutzen andere Tabellen und Bezeichnungen, Banken strukturieren ihre Auszüge nach eigenen Regeln, und selbst genormte Formulare werden in der Praxis unterschiedlich ausgefüllt. Wer glaubt, mit ein paar Musterdokumenten sei die Sache erledigt, irrt sich schnell.
Dokumenten Chaos
Hinzu kommen ganz praktische Stolpersteine, die dir aus dem Alltag vermutlich bekannt sind:
- schiefe oder unscharfe Scans
- schlecht erkennbare Zahlen
- mehrere Dokumente in einer einzigen PDF-Datei
- unterschiedliche Schreibweisen und Zahlenformate
- Tabellen mit Einzelwerten und Gesamtsummen
- ähnliche Dokumentarten mit unterschiedlicher steuerlicher Bedeutung
Ein System, das mit drei sorgfältig ausgewählten Lohnausweisen funktioniert, muss noch lange nicht mit dem echten Dokumentenchaos einer Treuhandgesellschaft zurechtkommen. Deshalb braucht es einen möglichst breiten und repräsentativen Datensatz - einen, der nicht nur einfache Beispiele enthält, sondern auch unterschiedliche Herausgeber, Layouts, Qualitätsstufen und bekannte Problemfälle abbildet.
Was Data Labelling wirklich bedeutet
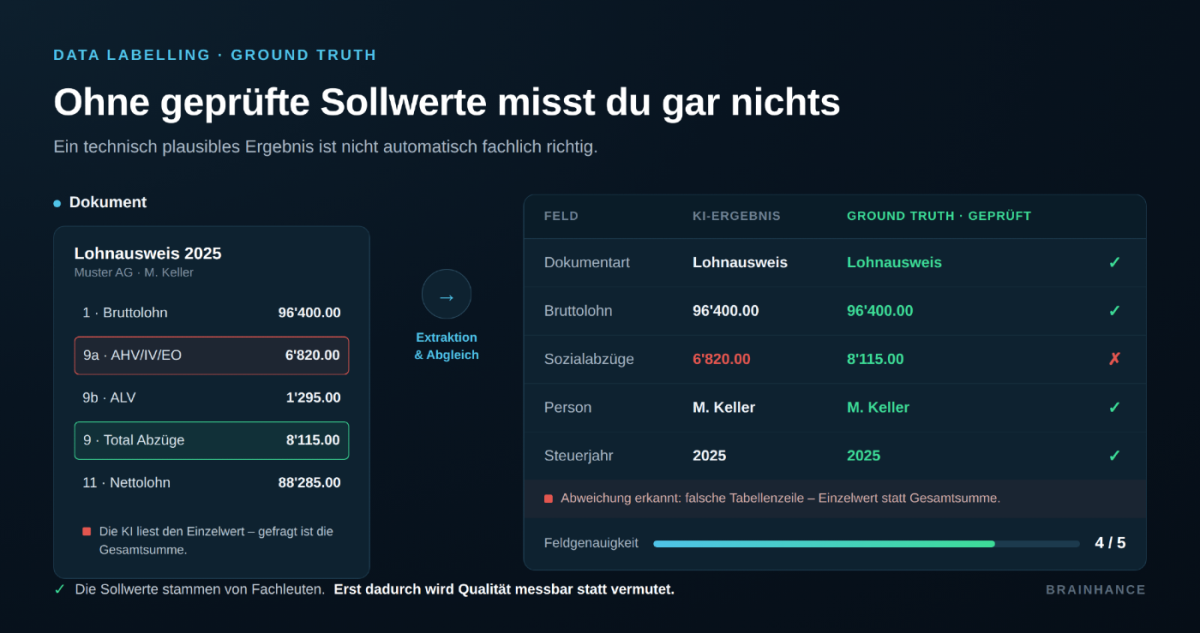
Damit sich die Qualität eines Systems überhaupt objektiv messen lässt, braucht jedes Testdokument ein erwartetes Ergebnis. Dieser Schritt heisst Data Labelling. Bei einem Lohnausweis hältst du dabei zum Beispiel fest:
- Um welche Dokumentart handelt es sich?
- Welcher Bruttolohn müsste erkannt werden?
- Welche Sozialabzüge sind ausgewiesen?
- Welche Person gehört zum Dokument?
- Welche weiteren steuerlich relevanten Angaben sind vorhanden?
Diese geprüften Sollwerte nennt man häufig Ground Truth. Gemeint ist damit nichts Geheimnisvolles, sondern schlicht die fachlich korrekte Referenz, an der sich das Ergebnis des Systems messen muss.
Gerade deshalb ist das Fachwissen von Treuhänderinnen und Treuhändern beim Aufbau solcher Testdaten unverzichtbar. Ohne diese Prüfung baust du dein System auf einem Fundament aus Vermutungen statt auf gesichertem Wissen.
Backtesting statt Stichproben
Bei einem Backtest lässt du die gesamte Verarbeitung automatisiert über einen bestehenden Testdatensatz laufen. Anschliessend vergleicht das System die erkannten Kategorien und Werte mit den hinterlegten Sollwerten. Kein Zufall, keine Momentaufnahme - sondern ein reproduzierbarer Check über die gesamte Breite deiner Dokumente.
Dadurch lässt sich einiges messen, was dir sonst verborgen bliebe:
- Wie viele Dokumente wurden richtig klassifiziert?
- Wie viele Felder wurden korrekt extrahiert?
- Bei welchen Dokumentarten treten Fehler auf?
- Wie lange dauert die Verarbeitung?
- Hat eine technische Änderung die Qualität verbessert oder verschlechtert?
Das ist besonders wichtig, weil eine Verbesserung an einer Stelle unbemerkt neue Fehler an anderer Stelle auslösen kann. Eine zusätzliche Prüfstufe klingt zunächst nach einer guten Idee, kann aber bereits korrekte Werte plötzlich verändern. Ohne einen vollständigen Backtest würde dir eine solche Verschlechterung womöglich erst im laufenden Betrieb auffallen - dann, wenn es am unangenehmsten ist.
Der Datensatz wächst mit dem System
Ein guter Testdatensatz ist nie fertig. Sobald im Betrieb ein neuer Sonderfall auftaucht, wird er anonymisiert, fachlich geprüft und als zusätzlicher Testfall aufgenommen. So entsteht mit der Zeit ein immer genaueres Abbild der tatsächlichen Arbeit in einer Treuhandgesellschaft. Jeder erkannte Fehler verbessert damit nicht nur ein einzelnes Dokument, sondern trägt dauerhaft zur Qualitätssicherung des gesamten Systems bei.
Zuverlässige KI-Extraktion entsteht deshalb nicht allein durch ein leistungsfähiges Modell. Sie entsteht durch das Zusammenspiel aus fachlich geprüften Daten, reproduzierbaren Tests und einem Prozess, der jede Änderung messbar macht.
Warum das stärkste Modell nicht automatisch die beste Wahl ist
Bei der Entwicklung einer KI-Lösung liegt ein Gedanke nahe: Nimm einfach das grösste und leistungsfähigste verfügbare Modell, dann müsste sich doch automatisch die höchste Qualität einstellen. Klingt logisch - ist in der Praxis aber oft ein Trugschluss.
Ein grösseres Modell kann spürbar langsamer und teurer sein, ohne bei einer klar abgegrenzten Aufgabe tatsächlich bessere Ergebnisse zu liefern. Bei der Dokumentenverarbeitung kommt es deshalb nicht darauf an, pauschal das stärkste Modell einzusetzen. Entscheidend ist vielmehr, für jeden einzelnen Verarbeitungsschritt die kleinste Lösung zu finden, die die erforderliche Qualität zuverlässig erreicht.
| Ansatz | Grösstes verfügbares Modell | Passend dimensioniertes Modell |
|---|---|---|
| Geschwindigkeit | oft langsamer | meist schneller |
| Kosten | in der Regel höher | in der Regel geringer |
| Qualität bei klar abgegrenzter Aufgabe | nicht automatisch besser | durch Tests messbar passend |
| Testbarkeit | schwerer zu optimieren | gezielt auf Aufgabe abstimmbar |
Backtest
Fazit: Qualität entsteht durch Prüfung, nicht durch Grösse
Wer eine verlässliche KI-Lösung für die Dokumentenverarbeitung aufbauen will, sollte sein Augenmerk weniger auf die Modellgrösse und mehr auf die Qualität der Testdaten legen. Ein breiter, realistischer Datensatz, saubere Ground-Truth-Werte durch Fachwissen und ein konsequenter Backtest bei jeder Änderung sind der eigentliche Schlüssel zu verlässlichen Ergebnissen. Nimm dir das als Denkanstoss: Prüfe bei deinem nächsten KI-Projekt zuerst, wie gut deine Testdaten wirklich sind, bevor du über das grösste Modell nachdenkst.
Was ist der Unterschied zwischen Dokumentenextraktion und Data Labelling?
Dokumentenextraktion beschreibt den eigentlichen Vorgang, in dem eine KI Informationen aus einem Dokument herausliest und strukturiert. Data Labelling ist die vorbereitende Arbeit, bei der Fachleute die korrekten Sollwerte für jedes Testdokument festlegen, damit sich die Qualität der Extraktion später überprüfen lässt.
Warum reicht ein kleiner Testdatensatz nicht aus?
Weil Dokumente derselben Kategorie in der Praxis sehr unterschiedlich aussehen können. Unterschiedliche Herausgeber, Layouts, Scanqualitäten und Sonderfälle sorgen dafür, dass ein System, das mit wenigen Beispielen gut funktioniert, im echten Arbeitsalltag trotzdem scheitern kann.
Was genau ist ein Backtest?
Bei einem Backtest wird die komplette Verarbeitung automatisiert über einen bestehenden Testdatensatz laufen gelassen. Die erkannten Werte werden anschliessend mit den geprüften Sollwerten verglichen, sodass sich Fehler und Qualitätsveränderungen zuverlässig messen lassen.
Ist ein grösseres KI-Modell automatisch besser?
Nein. Ein grösseres Modell kann langsamer und teurer sein, ohne bei einer klar abgegrenzten Aufgabe bessere Ergebnisse zu liefern. Sinnvoller ist es, für jeden Verarbeitungsschritt die kleinste Lösung zu wählen, die die geforderte Qualität nachweislich erreicht.
Wie bleibt ein Testdatensatz langfristig nützlich?
Indem er kontinuierlich weiterwächst. Jeder neue Sonderfall aus dem laufenden Betrieb wird anonymisiert, fachlich geprüft und als zusätzlicher Testfall aufgenommen, wodurch der Datensatz die reale Arbeit immer genauer abbildet.