Meta crawlt ab 30.10. deine Website: Was Werbekunden jetzt prüfen sollten

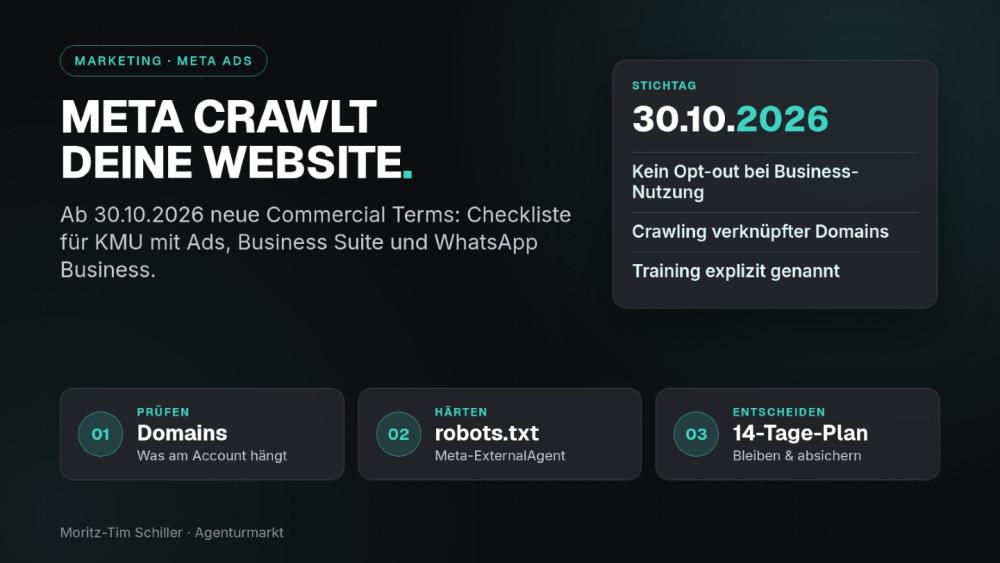
Meta crawlt ab 30.10. verknüpfte Websites: Checkliste für KMU mit Ads und Suite.
In diesem Beitrag: Was sich ab 30.10.2026 in den Meta Commercial Terms ändert, wen das betrifft, was Meta sagt, was Juristen warnen, und eine Checkliste plus 14-Tage-Plan für KMU mit Ads und Business Suite.
Ab dem 30. Oktober 2026 gelten aktualisierte Meta Commercial Terms für Business-Accounts. Neu ist eine Klausel, die Meta ausdrücklich erlaubt, mit Scrapern, Bots und Crawlern Domains und Seiten zu indexieren, zu cachen und auszuwerten, die mit deinen Produkten oder Services verknüpft sind oder über die Nutzung von Meta-Produkten bereitgestellt werden. Meta darf Inhalte laut Klausel auch nutzen, um Produkte zu entwickeln, zu verbessern, zu erforschen und zu trainieren.
Für dich als Werbekunde zählt das, weil die Klausel nicht nur Nachrichtenverlage trifft. Wer Facebook- oder Instagram-Ads schaltet, eine Seite betreibt, die Business Suite nutzt oder WhatsApp Business Messaging einsetzt, fällt unter die kommerzielle Nutzung. Ein Opt-out bei weiterem Business-Einsatz gibt es laut Berichten nicht: Wer nicht zustimmt, soll die geschäftliche Nutzung von Meta-Produkten einstellen.
Dieser Text ist eine praktische Orientierung für Entscheiderinnen und Entscheider in KMU, keine Rechtsberatung.
Was die neue Klausel konkret sagt
Berichte von Nieman Lab (15.10.2026) und Steampunk Explorer (14.10.2026) zitieren denselben neuen Absatz der Meta Commercial Terms. In der Sache autorisierst du Meta (oder jemanden in Metas Auftrag), automatisierte Software zu nutzen und Test-Zugangsdaten anzulegen, um Domains, Webseiten oder URLs zu erreichen, zu indexieren, zu cachen, zu analysieren, zu sammeln oder zu crawlen, die mit deinen Produkten oder Services verbunden sind oder über die Nutzung von Meta-Produkten verfügbar gemacht werden. Meta darf Updates periodisch nachziehen und Inhalte nutzen, um Meta-Produkte bereitzustellen, zu entwickeln, zu verbessern, zu erforschen, zu trainieren und integer zu halten.
Kurz und deutsch: Die Website, die du mit deinem Meta-Business-Account verknüpfst oder über Meta sichtbar machst, kann laut Klausel systematisch ausgelesen werden. Das gilt nicht nur für Beiträge, die du auf Facebook oder Instagram postest, sondern für Inhalte hinter den genannten Domains und URLs.
„You authorize us … to use automated software (such as web scrapers, bots, robots, spiders, crawlers …) and create test credentials to access, index, cache, analyze, collect, retrieve, or crawl the domains, web pages, or URLs … associated with your products or services … Meta may use any content … to provide, develop, improve, research, train, and maintain … Meta Company Products …“
Meta Commercial Terms (aktualisierte Klausel, zitiert nach Nieman Lab, 15.10.2026)
Wen das betrifft (nicht nur Verlage)
Betroffen sind Business-Accounts, die Seiten und Gruppen verwalten, Werbung schalten, Marketing-Nachrichten versenden oder die Business Suite bzw. das Business-Dashboard nutzen. Für den Mittelstand heißt das konkret:
- Meta Ads: Facebook- und Instagram-Kampagnen, auch wenn die Landingpage „nur“ deine Firmenwebsite ist.
- Seiten und Instagram Business: Firmenprofile, über die Traffic oder Leads laufen.
- WhatsApp Business Messaging: geschäftliche Nachrichten und Marketing über Meta.
- Business Suite / Business Manager: zentrale Verwaltung von Assets, Domains und Werbekonten.
Du musst kein Nachrichtenportal sein. Schon die Verknüpfung deiner Domain mit dem Werbekonto oder der Seite reicht aus Sicht der Klausel, um in den Kreis der „associated“ Domains zu geraten.
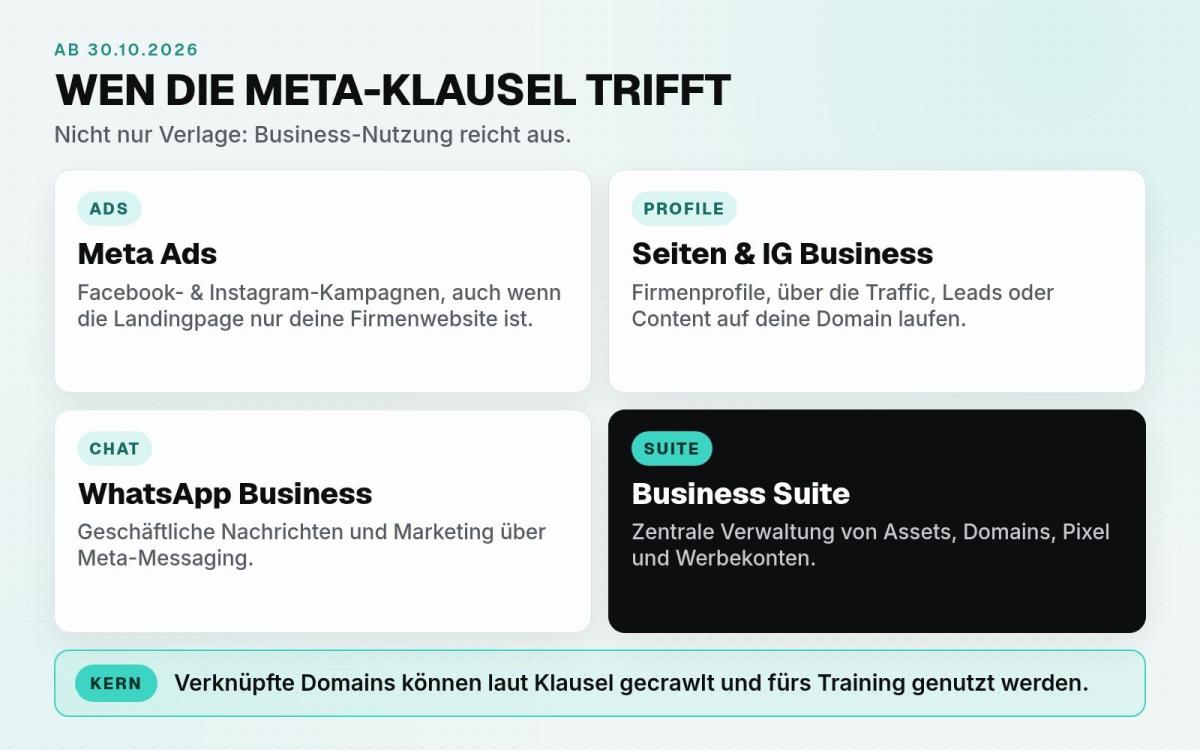
Wen Metas neue Commercial Terms treffen: Ads, Seiten, WhatsApp Business und Business Suite.
Was Meta sagt und was Juristen warnen
Ein Meta-Sprecher sagte gegenüber Nieman Lab und Steampunk Explorer sinngemäß: Die Crawl-Formulierungen seien zuvor über verschiedene Bedingungen verstreut gewesen und würden jetzt gebündelt; am Crawling von Publishern ändere sich dadurch nichts; Content-Eigentümer könnten den Zugriff weiterhin über robots.txt steuern.
Unabhängig davon dokumentiert Meta in Offenlegungen, die der Stanford CRFM Foundation Model Transparency Index zitiert, den Crawler Meta-ExternalAgent für Anwendungsfälle wie KI-Training und Produktverbesserung. Site-Betreiber können laut dieser Dokumentation in der robots.txt festlegen, wie Meta-Crawler mit der Site umgehen sollen, zum Beispiel mit User-agent meta-externalagent und Disallow für bestimmte Pfade. Der Crawler facebookexternalhit für Link-Vorschauen ist davon getrennt zu betrachten.
Juristische Einschätzungen, die Nieman Lab und Steampunk Explorer einholen, klingen vorsichtiger. Matt Topic hält die Klausel für bemerkenswert weit und rät Verlagen, von Durchsetzbarkeit auszugehen, auch wenn Gerichte das anders sehen könnten. James Grimmelmann warnt vor einer weiten Lesart, die Training und Archivierung erlauben könnte, und weist darauf hin, dass Test-Credentials theoretisch Registrierungswände umgehen könnten. Benjamin Sobel vergleicht die Kopplung von Plattformnutzung und Crawl-Erlaubnis mit „Tying“. Anwalt Babak Akhlaghi (Steampunk Explorer) sieht den Versuch, Fair-Use-Fragen vertraglich zu verschieben; das sicherste Opt-out sei, die Plattform zu verlassen; einseitige AGB-Updates werfen Fragen zu Zustimmung und Kenntnisnahme auf. All das ist Berichterstattung und Expertenmeinung, keine Rechtsberatung für deinen Einzelfall.
Checkliste vor dem 30.10.
Bevor du Panik machst oder Kampagnen abschaltest, lohnt ein ruhiger Rundgang durch Account und Website:
- Verknüpfte Domains auflisten: Welche Domains und Subdomains hängen am Business Manager, an der Seite, am Pixel oder an WhatsApp?
- Öffentliche vs. geschützte Bereiche: Was ist frei erreichbar, was hinter Login, Mitgliederbereich oder Shop-Checkout?
- Sensible Inhalte prüfen: Preislisten nur für Partner, Kundendaten-Exporte, interne PDFs, Demo-Zugänge mit echten Daten?
- robots.txt und Meta-Crawler: Existiert eine robots.txt? Ist Meta-ExternalAgent adressiert? Welche Pfade sollen gesperrt bleiben?
- Test-Credentials und Demo-Accounts: Gibt es öffentliche Registrierungen, Trial-Zugänge oder schwache Demo-Logins, die ein Bot anlegen könnte?
- Landingpages der Ads: Führen Kampagnen auf Seiten mit Inhalten, die du nicht in Trainingskorpora sehen willst?
- Drittplattformen: Shop, Blog, Hilfe-Center, Download-Bereich: alles, was „associated“ sein könnte, einmal inventarisieren.
- Verantwortung festlegen: Eine Person im Haus (Marketing, IT oder GF), die bis Ende Oktober entscheidet und dokumentiert.
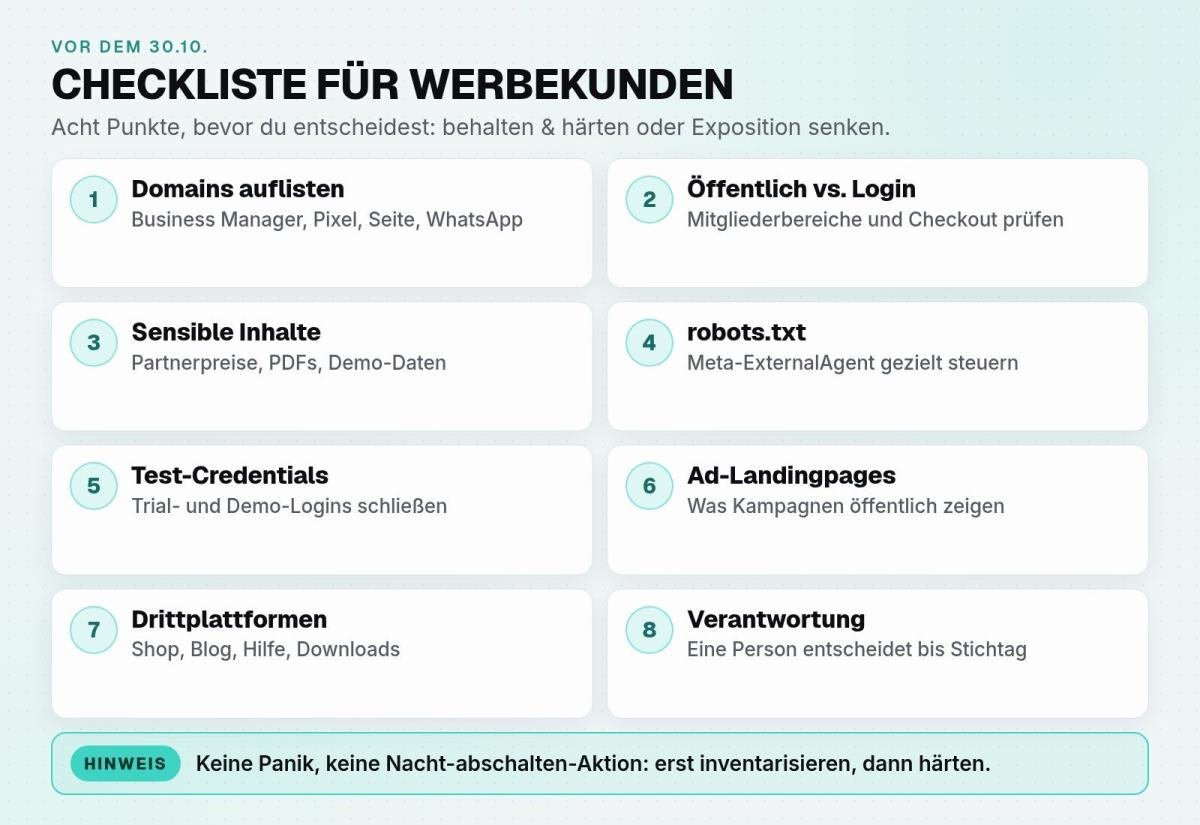
Acht Punkte vor dem 30.10.: Domains, Login-Bereiche, robots.txt und Ad-Landingpages prüfen.
Bleiben und härten oder Exposition reduzieren?
Die realistische Entscheidung für die meisten KMU ist kein Alles-oder-Nichts. Meta Ads und WhatsApp sind für viele Unternehmen zentrale Kanäle. Über Nacht alles abschalten kostet Reichweite und oft messbar Umsatz. Gleichzeitig ist „wir lesen die AGB nicht und hoffen“ keine Strategie.
Sinnvoller Rahmen:
- Behalten und härten: Kampagnen weiterlaufen lassen, aber Domains, Login-Bereiche und robots.txt aufräumen, sensible Inhalte hinter Auth legen, öffentliche Demo-Daten bereinigen.
- Exposition gezielt senken: Weniger Domains am Business-Account hängen, getrennte Marketing-Domain nutzen, kritische Inhalte nicht über Meta verlinkte URLs ausspielen.
- Teilweise zurückfahren: Nur wo der Nutzen klar unter dem Risiko liegt (etwa ein Content-Portal mit Lizenztexten), Reichweite über Meta reduzieren und andere Kanäle stärken.
Kein Ratschlag „Ads sofort killen“. Wohl aber: bis 30.10. bewusst entscheiden und die Entscheidung intern festhalten.
14-Tage-Plan bis zum Stichtag
- Tag 1–3: Inventar. Liste aller Meta-Business-Assets und verknüpften Domains. Screenshot oder Export der Business-Suite-Hinweistexte.
- Tag 4–6: Website-Audit. Öffentliche URLs, Login-Bereiche, robots.txt, Sitemap. Pfade mit Kundendaten, Preisgeheimnissen oder Downloads markieren.
- Tag 7–9: Härten. robots.txt für Meta-ExternalAgent setzen oder schärfen, wo gewünscht. Sensible Verzeichnisse sperren oder hinter Login legen. Schwache Demo-Accounts schließen.
- Tag 10–12: Ads und Landingpages. Prüfen, ob Anzeigen auf Seiten zeigen, die du nicht crawlen lassen willst. Gegebenenfalls Landingpages tauschen.
- Tag 13–14: Entscheidung dokumentieren. Bleiben und härten, Exposition senken oder Teilrückbau. Kurzes Memo an GF und, falls vorhanden, Datenschutzbeauftragte. Termin für Nachprüfung in 30 Tagen setzen.
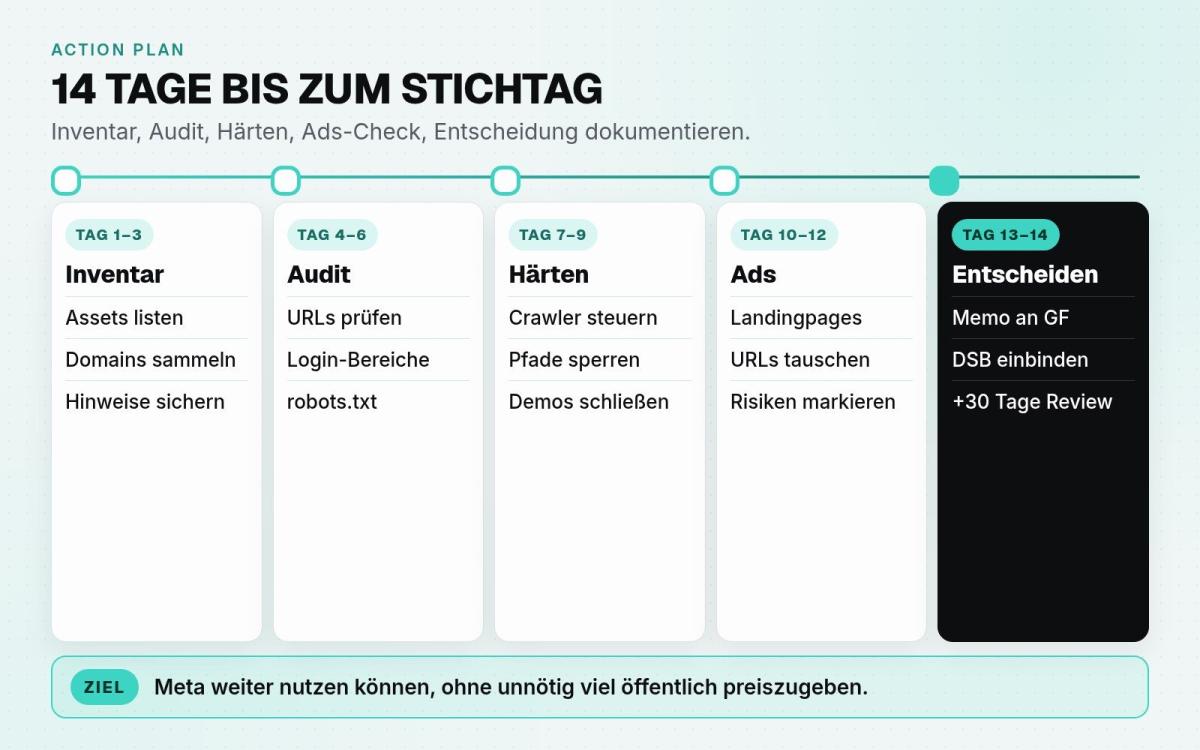
14-Tage-Plan: inventarisieren, Website härten, Ads prüfen, Entscheidung dokumentieren.
Wann externe Hilfe Sinn ergibt
Die Checkliste kannst du intern abarbeiten. Extern wird es sinnvoll, wenn viele Domains und Shops im Spiel sind, Login-Bereiche und robots.txt technisch unklar sind oder Marketing und IT aneinander vorbeireden. Dann hilft jemand, der Website, Tracking und Meta-Setup zusammen denkt.
Bei Taveno schauen wir uns genau solche Fragen im kostenlosen 30-minütigen Erstgespräch an: Welche Domains hängen am Account, was sollte öffentlich bleiben, was hinter Auth, und wie bleibt Performance-Marketing nutzbar, ohne unnötig viel preiszugeben. Termin über „Jetzt kontaktieren“ im Taveno-Profil auf Agenturmarkt oder über taveno.de. Wer erst selbst inventarisieren will, findet im Ressourcen-Bereich die Checkliste „KI-Sichtbarkeit in 30 Tagen“.
Fazit
Ab 30.10.2026 verknüpft Meta die weitere geschäftliche Nutzung seiner Produkte mit einer klaren Crawl- und Trainingsklausel für verknüpfte Websites. Meta verweist auf Konsolidierung und robots.txt; Juristen warnen vor weiter Auslegung und Test-Credentials. Für KMU mit Ads und Business Suite heißt das: inventarisieren, härten, entscheiden. Nicht panisch, aber rechtzeitig.
Häufige Fragen
Betrifft das nur Nachrichtenwebsites?
Nein. Die Berichte betonen Business-Accounts mit Ads, Seiten, Marketing-Nachrichten und Business Suite. Auch eine ganz normale Firmenwebsite kann betroffen sein, sobald sie mit dem Meta-Business-Einsatz verknüpft ist.
Reicht robots.txt als Schutz?
Meta sagt öffentlich, Content-Eigentümer könnten den Zugriff weiter über robots.txt steuern, und dokumentiert Meta-ExternalAgent mit Opt-out über robots.txt. Ob die neuen Commercial Terms diese Steuerung in der Praxis und vor Gericht immer Vorrang haben, ist laut befragten Juristen offen. robots.txt bleibt ein sinnvolles, aber kein alleiniges Werkzeug.
Muss ich Meta Ads abschalten?
Nicht zwingend. Viele Betriebe werden nutzen und gleichzeitig härten. Abschalten ist die klarste Ablehnung der neuen Bedingungen, hat aber wirtschaftliche Folgen. Die Entscheidung gehört zur Geschäftsführung, idealerweise mit kurzer Dokumentation.
Ist das rechtlich schon geklärt?
Nein. Durchsetzbarkeit, Fair Use, Zustimmung zu einseitigen AGB-Updates und die Reichweite von „associated“ Domains sind laut den zitierten Expertinnen und Experten umstritten bzw. ungeklärt. Dieser Artikel ersetzt keine anwaltliche Beratung.
Über den Autor: Moritz-Tim Schiller ist Gründer von Taveno Solutions in Oberhausen, einer Digitalagentur für KMU mit Fokus auf Websites, KI-Agenten, Automatisierung und Performance-Marketing. Er beschäftigt sich unter anderem damit, wie kleine und mittlere Unternehmen Meta-Werbung und Website-Technik so verbinden, dass Reichweite bleibt und Risiken sichtbar werden.