Supportantworten im Produkt: Was deine Software belegen muss

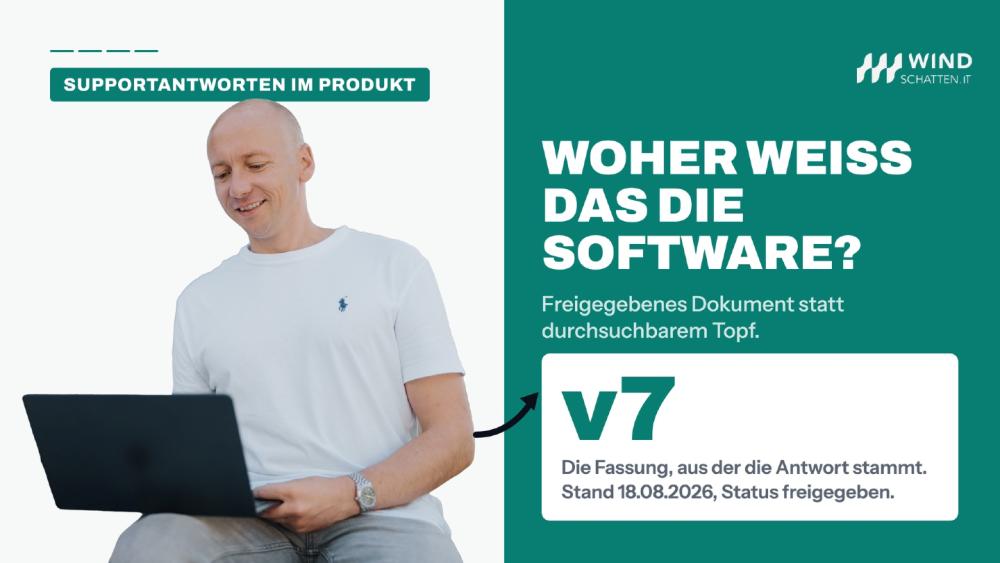
Demo-Ansicht: Die Antwort nennt Dokumentfassung v7 und ihren Stand vom 18.08.2026.
Im Hilfefeld deines Produkts tippt eine Kundin ihre Frage ein. Sie will wissen, welche Wartungsanleitung für ihr Modul MX-204 gilt. Kurz darauf steht eine Antwort da, flüssig formuliert, mit einer Anleitung darin. Ob die noch gilt, merkt dein Support erst, wenn die Kundin den Satz zwei Wochen später zitiert. Eine Antwort, die ihre Herkunft nicht zeigt, ist eine Behauptung.
Du kannst das auch anders bauen. Deine Software zieht die Antwort dann nur aus den Anleitungen, die dafür freigegeben sind, und aus den wenigen Kundendaten, die sie für genau diese Person öffnen darf. In der Antwort steht, aus welchem Dokument sie stammt, in welcher Version, und wie aktuell die verwendeten Kundendaten waren. Deine Kundin erkennt damit sofort, ob die Anleitung auf ihr Gerät passt, und du bekommst eine Auskunft, die dein Unternehmen im Zweifel vertreten kann. Entschieden wird das in der Reihenfolge, in der du die Funktion baust.
Die Reihenfolge entscheidet über die Antwortqualität
Der übliche Bauweg beginnt beim Wissen. Man sammelt Handbücher, Hilfeartikel, Ticketverläufe und Vertragsdokumente, macht alles durchsuchbar und lässt ein Sprachmodell daraus formulieren. Ein Sprachmodell ist dabei nur der letzte Handgriff, also das Stück Software, das aus vorgelegtem Material einen lesbaren Satz baut.
Wer stattdessen bei den Rechten anfängt, dreht die Reihenfolge um. Zuerst stellt deine Software fest, wer da fragt. Sie kennt die angemeldete Person, ihr aktives Kundenkonto und ihre Rolle. Daraus leitet sie ab, welche Art von Frage erlaubt ist und welche Daten dafür gelesen werden dürfen.
Danach holt sie zwei Quellen getrennt voneinander. Aus deinen freigegebenen Dokumenten kommt die Wartungsanleitung mit der Kennung KB-MX-17, Version 7, Stand 18. August 2026. Aus dem System, in dem die Kundendaten wirklich stehen, kommen Produktreihe, Variante und Land, jeweils mit Datum. Mehr nicht.
Das Sprachmodell wählt davon nichts aus. Es bekommt vorgelegt, was deine Software freigegeben hat, und formuliert daraus einen Satz. Maßgeblich bleibt das angemeldete Konto. Tippt jemand die Kundennummer eines fremden Kontos in seine Frage, öffnet das keine einzige Zeile mehr.
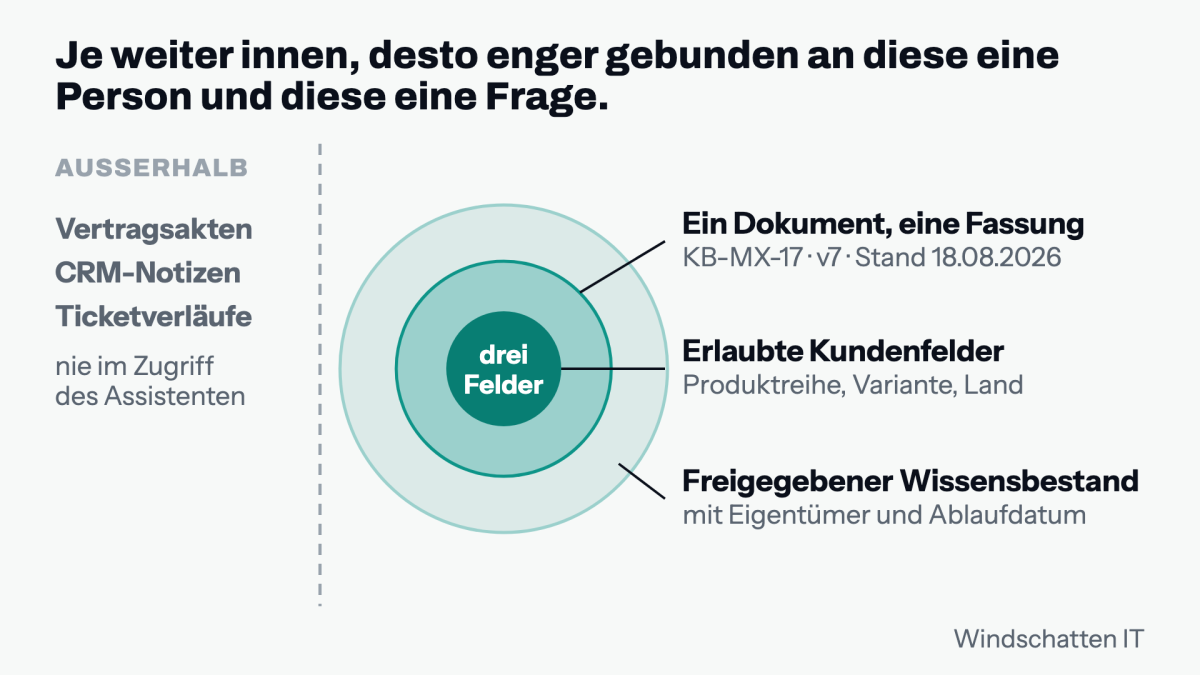
Schema der vorgeschlagenen Zugriffsordnung: im Kern drei erlaubte Kundenfelder für genau diese Person, darum das freigegebene Dokument in seiner Fassung. Vertragsakten, CRM-Notizen und Ticketverläufe liegen außerhalb der Grenze. Alle Angaben sind Demo-Werte.
| Prüfpunkt | Gut klingende Antwort | Belegte Antwort |
|---|---|---|
| Quelle | ungenannt | Dokument mit Kennung und Version |
| Aktualität | unbekannt | Stand des Dokuments und der Kundendaten sichtbar |
| Kundenbezug | erschlossen | von deiner Software freigegebene Felder |
| Wissenslücke | wird überbrückt | Antwort wird gesperrt |
| Nachprüfbarkeit | keine | Herkunft jeder Aussage benannt |
Was passiert, wenn alles im selben Topf liegt
Wer Vertragsakten, CRM-Notizen und Ticketverläufe in denselben durchsuchbaren Bestand legt, verliert die Kontrolle über den einzelnen Satz. HubSpot, Anbieter für Vertriebs- und Servicesoftware, schreibt das in der eigenen Dokumentation ausdrücklich hin. Jeder hinterlegte Inhalt steht für Antwortentwürfe zur Verfügung. Private Quellen werden zwar nicht zitiert, ihr Inhalt kann trotzdem in Antworten erscheinen. HubSpot rät deshalb davon ab, persönliche, vertrauliche oder sensible Informationen und private Kundendaten dort abzulegen.
Atlassian trennt das über zwei Konten. In Jira und Confluence steuert ein Konto, welche Inhalte überhaupt in den Suchbestand wandern. Ein zweites Konto gehört zum Assistenten und legt fest, was dieser daraus verwenden darf. Was dieses Konto nicht sehen darf, bleibt auch für den Assistenten unsichtbar.
Beide Hersteller beschreiben dieselbe Grenze, jeder von seiner Seite. Diese Grenze hält der Login allein nicht. Die Sicherheitsorganisation OWASP verlangt bei jeder einzelnen Abfrage eine erneute Rechteprüfung auf dem Server, sobald ein Datensatz über seine Kennung angefordert wird.
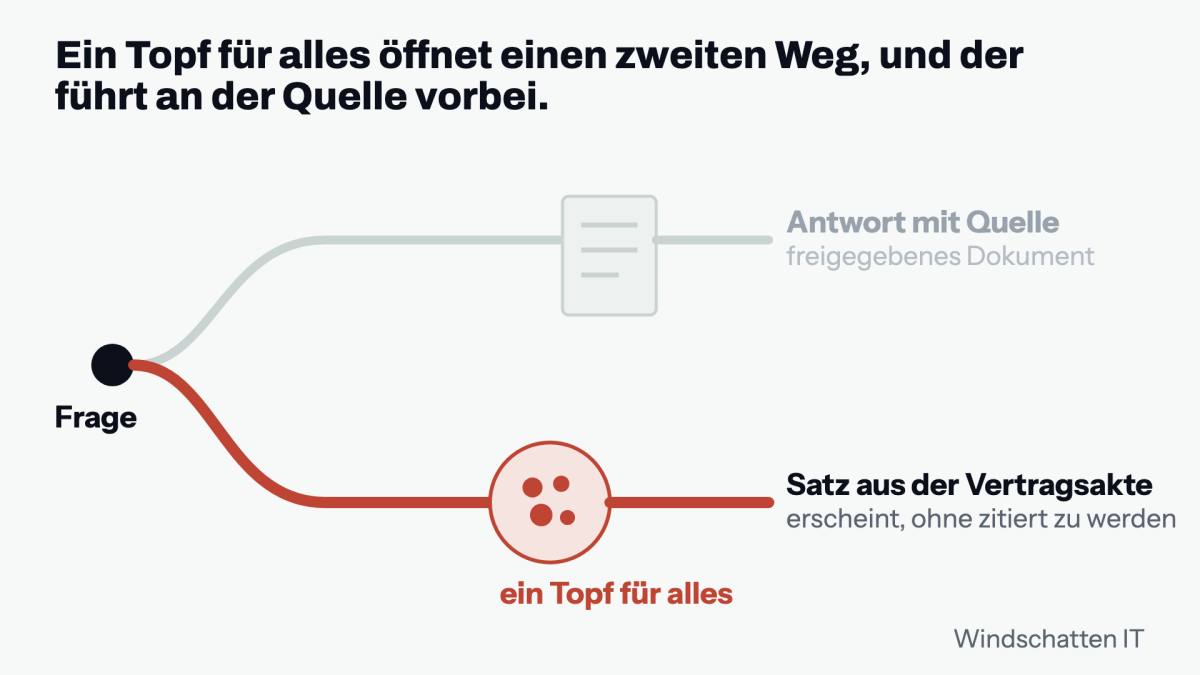
Schema der beiden Wege: über das freigegebene Dokument entsteht eine Antwort mit Quelle. HubSpot dokumentiert für sein eigenes Produkt, dass Inhalte privater Quellen in Antworten erscheinen können, ohne zitiert zu werden (Seitenstand 29. Juli 2026).
Eine falsche Auskunft wird zu deinem Vorgang
Der erste Grund, warum dich das betrifft, ist Haftung. Was dein Produkt antwortet, muss dein Unternehmen im Zweifel vertreten. Sagt die Software etwas Falsches über Leistungsumfang, Vertrag oder Preis, korrigiert der Support, die Kundin ist verärgert, und am Ende diskutierst du über eine Zusage, die niemand gegeben hat. Deshalb bleiben solche Aussagen ohne freigegebene aktuelle Quelle in dieser Funktion gesperrt.
Zweitens hängt daran der Produktwert. Ob deine Kunden eine belegte Antwort honorieren, hängt an deinem Markt. Wo sie es tun, hast du im Vertriebstermin etwas Vorzeigbares, nämlich die Antwort und daneben die Dokumentkennung, aus der sie stammt.
Bleibt die Entlastung im Support. Belastbare Zahlen dazu habe ich nicht.
Wie oft solche Fragen in deinem Produkt auftreten, wie gut deine heutige Suche sie löst und was der bisherige Weg kostet, ist nicht erhoben. Diese Zahlen holst du dir vor dem Bau.
Woran du vor dem Start erkennst, ob es taugt
Antwortqualität prüfst du mit festen Testfällen, lange bevor du über Wirkung sprichst. Das würde ich zuerst durchspielen.
- Eine eindeutige Wissensfrage trifft die richtige Quelle in der richtigen Version.
- Fragt jemand nach einem fremden Kundenkonto, endet die Antwort neutral. Sie bestätigt nicht einmal, dass es dieses Konto gibt.
- Eine abgelaufene Quelle führt zur Sperre.
- Widersprechen sich zwei Dokumente, bricht die Antwort ab und der Fall geht an einen Menschen.
- Schreibt jemand eine Anweisung in einen Anhang, behandelt die Software sie als Zitat und führt sie nicht aus.
- Die Übergabe an einen Menschen enthält die Frage, den erlaubten Bereich, die benutzten Quellen und den Grund.
Falsche, veraltete und unvollständige Quellen sind dabei eine eigene Fehlerklasse, und Intercom listet sie als eigenen Prüffall in Testläufen über ganze Fragensammlungen. Salesforce beschreibt vergleichbare Testläufe und schreibt dafür eine abgetrennte Testumgebung vor, weil ein Testlauf CRM-Daten verändern kann. Diese Grenze gilt für Salesforce. Übertrage sie nicht ungeprüft auf dein eigenes Produkt.
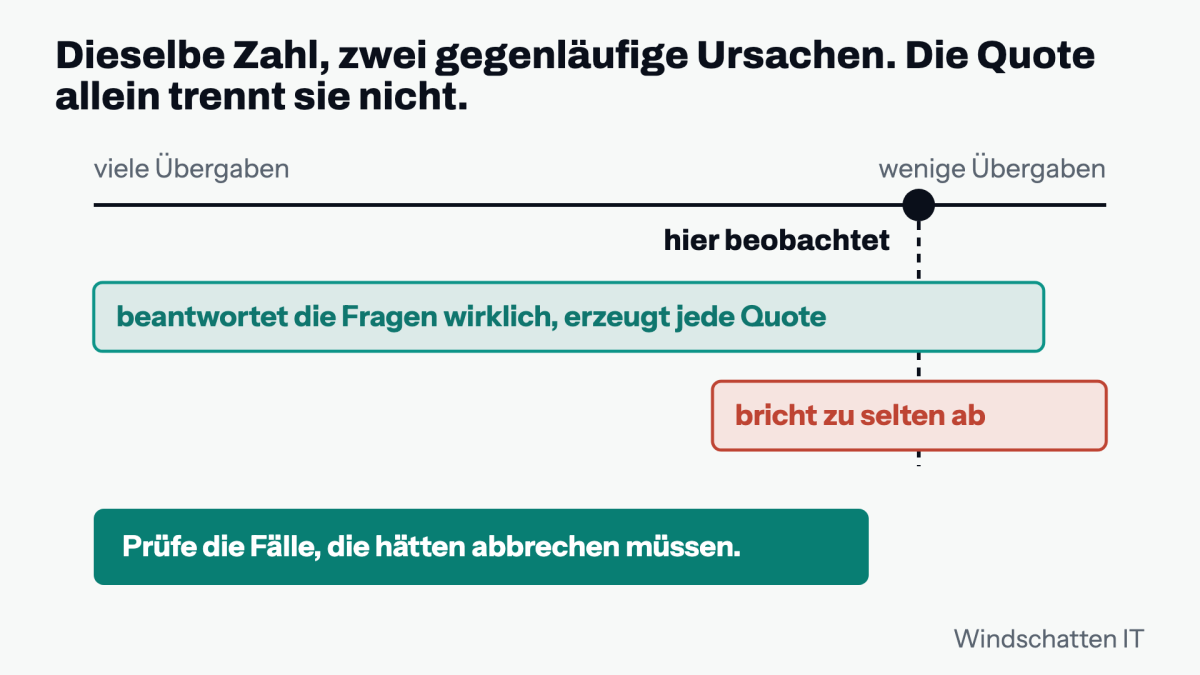
Schema zur Auswertung: Eine belegte Antwort- oder Übergabequote gibt es im Artikel nicht. Gezeigt ist, warum dieselbe Beobachtung zwei gegenläufige Ursachen haben kann und woran sich beide trennen lassen.
Fazit: Die Arbeit steckt vor dem Code
Die Aufgabe davor ist unspektakulär. Du legst fest, welche Art von Fragen dein Produkt überhaupt bedienen soll. Für jede Aussage darin bestimmst du ein verbindliches Dokument mit Eigentümer, Version und Ablaufdatum. Dazu kommt die Frage, welches System die Kundendaten liefert und wie alt sie sein dürfen.
Wenn dabei herauskommt, dass eine rechtegeprüfte Suche dieselben Dokumente ohne Zwischenschicht zeigt, dann ist die Suche die bessere Lösung. Die Vorarbeit hat dir dann einen Dialogaufbau erspart, den du sonst über Jahre pflegen müsstest.
Am Ende steht eine Auskunft, die dein Support in einem Ticket zitieren kann, ohne vorher nachzusehen. Fehlt diese Grundlage, holt die Software einen Menschen dazu.
Reicht es nicht, wenn der Kunde eingeloggt ist?
Der Login belegt die Identität, mehr nicht. Entscheidend ist der Zeitpunkt der Prüfung. Wer nur beim Einstieg prüft, arbeitet den Rest der Sitzung mit Rechten von vorhin, und die ändern sich zwischen zwei Fragen. Fehlt die Prüfung ganz, entscheidet am Ende das Sprachmodell darüber, was es liest.
Landen unsere Kundendaten dadurch im Sprachmodell?
Als einzelne, klar benannte Felder, nie als ganzes CRM-Dokument und nie als Ticketverlauf. Zwischengespeicherter Kontext muss verfallen, sobald jemand die Rolle wechselt oder das Konto verliert. Sonst hängt im Zwischenspeicher eine Auskunft, die zum Zeitpunkt der Frage niemand mehr hätte bekommen dürfen.
Wer im Unternehmen muss dafür Arbeit leisten?
Der Service legt fest, welche Frageklassen überhaupt zugelassen sind und wo der Weg zum Menschen verläuft. Für jedes Dokument braucht es danach jemanden, der Freigabe und Ablaufdatum wirklich pflegt. Ohne festen Eigentümer bleibt genau diese Pflege liegen. Dazu kommen die Fachleute, die für die Bedeutung eines Datenfelds geradestehen, und eure IT-Sicherheit für Konten und Zugriffsgrenzen.
Ist eine gute Suche nicht die einfachere Lösung?
Oft ja. Faustregel: Solange eine Frage mit einem einzigen freigegebenen Dokument vollständig beantwortet ist, gewinnt die Suche. Sie zeigt das Dokument direkt, und du sparst dir den kompletten Prüfaufbau. Erst wenn eine Antwort mehrere Dokumente und den Kundenkontext zusammenführen muss, lohnt der Dialog den Aufwand.
Was tun wir mit Fragen, für die es dauerhaft keine Quelle gibt?
Die gehören nicht in die Funktion, sondern auf eine Liste. Hinter jeder solchen Frage steckt entweder ein fehlendes Dokument oder ein bewusst menschlicher Fall. Die Liste fällt bei der Vorarbeit ohnehin an. Sie zeigt, wo dein Servicewissen Lücken hat.