Rechnungen per KI auslesen? Wozu eigentlich, wenn es auch ohne geht

Erst prüfen, ob die Rechnungsverarbeitung ein Sprachmodell braucht.
Neulich stolperte ich über einen LinkedIn-Beitrag, der auf den ersten Blick nach einer echten Erfolgsgeschichte klang: Ein Unternehmen lässt seine chaotischen PDF-Rechnungen von einem lokalen KI-Modell auslesen, komplett offline, ohne Cloud-Anbieter, ohne dass sensible Finanzdaten das Haus verlassen. Klingt smart, klingt modern, klingt nach einem Paradebeispiel für praxisnahe KI im Mittelstand.
Je länger ich aber darüber nachdachte, desto mehr drängte sich mir eine andere Frage auf: Wofür genau brauchen wir hier eigentlich künstliche Intelligenz? Nicht ob das Modell lokal, in der Cloud oder bei irgendeinem Anbieter zwischen Frankfurt und Singapur läuft, sondern ob überhaupt ein Sprachmodell nötig ist, um das Problem zu lösen. Genau dieser Frage will ich mich hier stellen, ganz bewusst etwas zugespitzt und unbequem.
Was beim Rechnungs-Use-Case tatsächlich passiert
Schauen wir uns nüchtern an, was beim Verarbeiten von Rechnungen technisch verlangt wird. Es geht darum, Text aus PDFs zu extrahieren, Rechnungsnummer, Datum und Betrag zu erkennen, fehlende Pflichtangaben zu identifizieren und die Daten am Ende in ein einheitliches, weiterverarbeitbares Format zu bringen. Klingt nach einer Aufgabe für künstliche Intelligenz. Ist es aber, ehrlich betrachtet, seit vielen Jahren nicht mehr.
Für jeden dieser Schritte gibt es längst bewährte, klassische Lösungen, die ganz ohne generative Sprachmodelle auskommen:
- Text aus digitalen PDFs auslesen: Das erledigen PDF-Parser zuverlässig und schnell.
- Rechnungsnummer, Datum, Betrag erkennen: Vorlagen und reguläre Ausdrücke leisten hier seit Jahrzehnten gute Dienste.
- Pflichtangaben und Regelverstöße prüfen: Schemavalidierung und festprogrammierte Prüfregeln, wie sie zum Beispiel der KOSIT-Validator nutzt, machen genau das zuverlässig.
- Gescannte Rechnungen einlesen: Klassische Texterkennung (OCR), teils auf Basis neuronaler Netze, aber eben ohne Sprachmodell und ohne generative KI.
Das Programm Dativ und vergleichbare Tools lösen dieses Problem übrigens schon, seit es die Diskussion um Chat-GPT und Co. noch gar nicht gab. Der Use-Case "unstrukturierte Rechnungsdaten in ein sauberes Format bringen" ist so alt wie die digitale Buchhaltung selbst.
Wo Sprachmodelle wirklich einen Unterschied machen könnten
Ganz so schwarz-weiß, wie es jetzt klingen mag, ist die Sache dann aber doch nicht. Es gibt tatsächlich einen Punkt, an dem ein Sprachmodell einen echten Mehrwert bringen könnte: bei ständig wechselnden Rechnungslayouts. Wenn jeder Lieferant sein eigenes Format mitbringt und sich Vorlagen laufend ändern, stoßen starre Regeln und feste Templates schnell an ihre Grenzen. Hier kann ein KI-Modell flexibler auf neue Strukturen reagieren als ein hart codierter Parser.
Doch selbst dann würde ich klar trennen zwischen zwei Aufgaben: dem Erkennen und Extrahieren von Informationen aus unterschiedlichen Layouts einerseits, und dem anschließenden Prüfen von Summen und Pflichtfeldern andererseits. Für die Extraktion mag ein Sprachmodell bei wechselnden Formaten Vorteile bringen. Die Prüfung selbst, ob eine Summe stimmt oder ein Pflichtfeld fehlt, gehört meiner Meinung nach weiterhin in klar definierten Code und nicht in ein Sprachmodell, das im Zweifel auch mal danebenliegen kann.
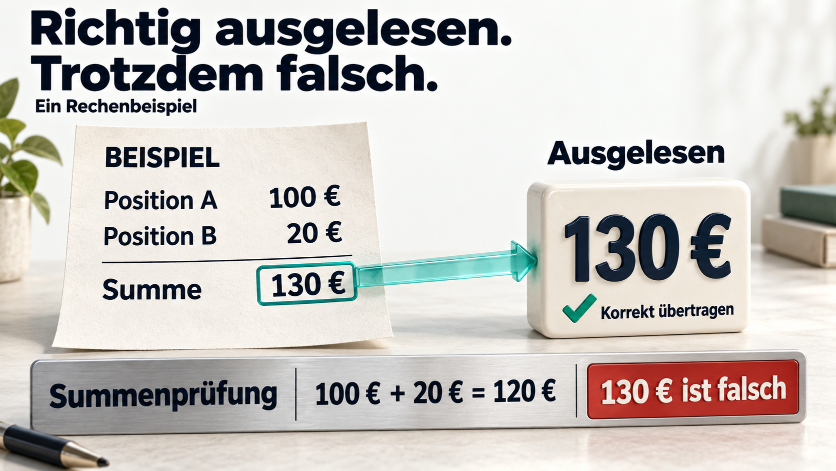
Rechenbeispiel: Eine korrekt ausgelesene Summe kann rechnerisch trotzdem falsch sein.
Genau hier fehlt es in der öffentlichen Diskussion oft an handfesten Vergleichszahlen. Wie hoch ist die Fehlerquote eines Sprachmodells im Vergleich zu einer klassischen Schemavalidierung? Wie viel Wartungsaufwand entsteht auf beiden Seiten wirklich? Ohne solche Zahlen bleibt die Behauptung, KI löse das Problem besser, erst einmal eine unbelegte Annahme.
Lokal, Cloud oder Bedrock: Die eigentlich falsche erste Frage
Dass ein Modell komplett lokal läuft und keine Daten das Haus verlassen, beantwortet eine wichtige Frage: die nach dem Datenschutz. Sie beantwortet aber nicht die viel grundsätzlichere Frage, ob überhaupt ein KI-Modell zum Einsatz kommen sollte. Ob lokal, in der EU-Cloud, bei Bedrock oder sonst wo gehostet, spielt erst eine Rolle, wenn feststeht, dass ein Sprachmodell für die Aufgabe tatsächlich gebraucht wird.
| Aufgabe | Klassische Lösung | Braucht wirklich KI? |
|---|---|---|
| Text aus digitalem PDF lesen | PDF-Parser | Nein |
| Felder aus bekanntem Format extrahieren | Vorlagen, reguläre Ausdrücke | Nein |
| Pflichtfelder und Formalfehler prüfen | Schemavalidierung, feste Prüfregeln | Nein |
| Gescannte Rechnung einlesen | OCR (auch mit neuronalen Netzen) | Nein |
| Stark wechselnde, unbekannte Layouts erkennen | Klassische Regeln stoßen an Grenzen | Möglicherweise ja |
Der Denkfehler, der viele KI-Projekte teuer macht
Der eigentliche Denkfehler in vielen KI-Projekten liegt selten in der Technik selbst, sondern in der Reihenfolge der Fragen. Zuerst wird entschieden, dass KI zum Einsatz kommen soll, danach überlegt man sich, wo sie laufen darf und wie man sie am besten integriert. Die viel wichtigere Frage, ob die Aufgabe überhaupt ein Sprachmodell braucht, bleibt dabei oft auf der Strecke.
Dabei lohnt sich genau diese Frage besonders. Nicht selten steckt hinter einer vermeintlichen KI-Lösung am Ende doch nur ein gut verpacktes Skript, das dieselbe Aufgabe übernimmt, die vorher schon ein klassisches Programm erledigt hat, nur mit deutlich mehr Rechenaufwand, höheren Kosten und einer schwerer nachvollziehbaren Fehlerquelle.
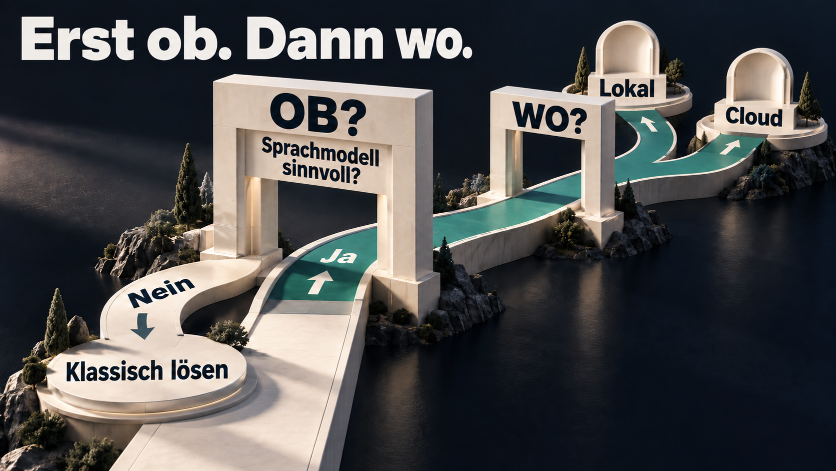
Schematische Illustration: Erst den Bedarf klären, dann zwischen lokal und Cloud wählen.
Fazit: Erst der Use-Case, dann die Technologie
Lokale KI, die sensible Daten im Haus behält, ist grundsätzlich eine gute Idee, keine Frage. Aber sie ist die Antwort auf die Frage nach dem "Wo", nicht auf die Frage nach dem "Warum". Bevor du dich für ein Sprachmodell entscheidest, egal ob lokal oder in der Cloud betrieben, lohnt sich der ehrliche Blick auf die Aufgabe: Gibt es dafür längst eine klassische, robuste und günstigere Lösung? Bei strukturierten und halbstrukturierten Rechnungen lautet die Antwort meistens: ja.
Nimm dir bei deinem nächsten KI-Projekt bewusst Zeit für diese Vorprüfung. Skizziere den Workflow, identifiziere die einzelnen Schritte und prüfe für jeden davon, ob ein Parser, eine Regel oder eine Validierung nicht genauso gut funktioniert wie ein Sprachmodell. Nur wenn am Ende ein Schritt übrig bleibt, der von echter Flexibilität und Sprachverständnis profitiert, hat der Einsatz von KI wirklich seine Berechtigung.
Brauche ich für die Rechnungsverarbeitung wirklich KI?
In den meisten Fällen nicht. PDF-Parser, Vorlagen, reguläre Ausdrücke und Schemavalidierung lösen die klassischen Aufgaben wie Datenextraktion und Pflichtfeldprüfung zuverlässig und ohne Sprachmodell.
Wann lohnt sich ein Sprachmodell trotzdem?
Besonders dann, wenn Rechnungslayouts sich häufig und unvorhersehbar ändern und starre Vorlagen an ihre Grenzen stoßen. Hier kann ein Sprachmodell bei der Extraktion flexibler reagieren.
Ist lokale KI automatisch die bessere Wahl?
Lokale KI löst vor allem Datenschutzfragen, weil Dokumente das Haus nicht verlassen. Sie beantwortet aber nicht, ob ein KI-Modell für die Aufgabe überhaupt notwendig ist.
Wie erkenne ich, ob mein Problem klassisch oder mit KI gelöst werden sollte?
Zerlege den Workflow in einzelne Schritte und prüfe für jeden, ob eine feste Regel, ein Parser oder eine Validierung ausreicht. Bleibt danach noch ein Schritt übrig, der echtes Sprachverständnis braucht, ist KI die richtige Wahl.
Gibt es Nachteile, wenn ich KI einsetze, obwohl es nicht nötig wäre?
Ja, häufig entstehen dadurch höherer Rechenaufwand, mehr Kosten, eine schwerer nachvollziehbare Fehlerquelle und zusätzlicher Wartungsaufwand, ohne dass sich das Ergebnis wirklich verbessert.