Warum deine Agentur nicht auf ein einziges KI-Modell setzen sollte...

Warum man sich nie in die Abhängigkeit von KI Modellen begeben sollte
Stell dir vor, du wachst morgens auf und dein wichtigstes Arbeitswerkzeug ist einfach weg. Nicht kaputt. Nicht langsam. Sondern komplett abgeschaltet.
Dein bestes KI-Modell gehört dir nicht. Es kann verschwinden – aus Gründen, die nichts mit deiner Arbeit zu tun haben. Geopolitik, Exportrecht, ein Brief eines Ministeriums. Und plötzlich steht deine komplette Delivery still.
Selbst-Hosting klingt verlockend – aber ist es das auch?
Die naheliegende Reaktion vieler ist klar: "Dann hoste ich eben alles selbst."
Eigene Hardware, eigene Modelle, keine Abhängigkeit mehr. Klingt nach Kontrolle und Souveränität. Aber zwischen "ich kann ein Modell lokal laufen lassen" und "ich habe einen produktiven KI-Agenten" liegen Welten.
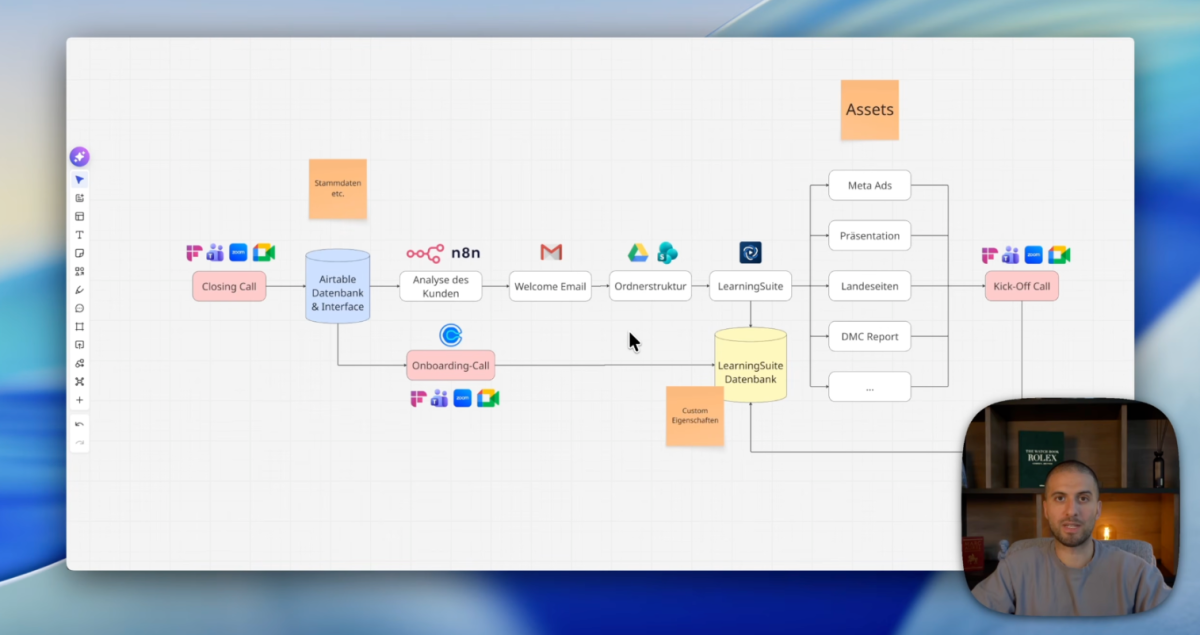
Im kostenlosen Beratungsgespräch visualisieren wir gemeinsam, wie Prozesse, Systeme und Automatisierungen heute zusammenspielen und wo konkrete Hebel liegen. Daraus entsteht eine individuelle Prozess- und Automatisierungsmap, die Potenziale sichtbar macht und eine klare Grundlage für die nächsten Umsetzungsschritte schafft.
Selbst-Hosting ist nämlich kein einfacher Schalter, den du umlegst. Es ist ein Spektrum mit sehr unterschiedlichen Stufen:
Die drei Ebenen des Selbst-Hostings
- Ganz unten: Winzige lokale Modelle auf einem Mac Mini oder Gaming-PC. Für einen einfachen Chatbot reicht das vielleicht. Aber sobald das Modell Tools nutzen, Kontext halten und komplexe Aufgaben wirklich zu Ende bringen soll, bricht es ein.
- Ganz oben: Die echten Frontier-Modelle wie GPT oder Opus. Sie lassen Agenten-Workflows magisch wirken – sind aber weder Open-Weight noch so ressourcenhungrig, dass du sie auf keiner realistischen Hardware selbst hosten kannst.
- In der Mitte: Hier wird es spannend. Open-Weight-Modelle, die groß genug sind, um nützlich zu sein, und klein genug, um auf gemieteter Infrastruktur zu laufen. Anbieter wie Vast vermieten dir stundenweise ernsthafte Hardware – A100s, H100s, Data-Center-GPUs. Genau hier entscheidet sich, ob Selbst-Hosting für Agenturen real wird oder eine Spielerei bleibt.
Was bei Agenten wirklich zählt
Ein guter Leaderboard-Score bedeutet nichts, wenn das Modell im echten Workflow versagt. Für agentische Arbeit sind drei Dinge entscheidend:
- Tool-Use: Ruft das Modell das richtige Tool zur richtigen Zeit mit den richtigen Argumenten auf? Klingt banal, genau hier scheitern schwache Modelle sofort.
- Kontext: Bei einem Agenten ist der Kontext sofort voll – Instruktionen, Tool-Schemas, Nachrichten, Datei-Inhalte, Fehler. 16.000 Token sind das absolute Minimum, nicht das Ideal.
- Quantisierung: Das ist Kompression für Modellgewichte. Du sparst VRAM, aber verlierst Qualität. Bei einem Chatbot merkst du das kaum. Bei einem Agenten bricht der ganze Workflow zusammen.
Die drei Stufen – mit Preisschildern
Stufe 1: Qwen3-Coder 30B (der Einstieg)
Läuft auf einer Workstation-GPU mit viel VRAM, etwa einer RTX Pro 6000 mit 96 GB. Kosten: rund 1 Dollar pro Stunde. Im Dauerbetrieb sind das circa 700 Dollar im Monat – bevor du an Storage und Bandbreite denkst. Das Modell eignet sich für Entwürfe, strukturierte Zusammenfassungen und klare Tool-Workflows. Sobald es aber unsauber oder mehrstufig wird, verliert es schnell die Orientierung.
Stufe 2: MiniMax M2 (die ernsthafte Mitte)
Hier wird es anspruchsvoll. Die Gewichte brauchen rund 220 GB. Du landest bei Maschinen wie 4x A100 80 GB, grob 3 bis 5 Dollar pro Stunde. Im Dauerbetrieb: 2.000 bis 3.000 Dollar im Monat. Dafür ist das das erste Modell, das sich im Agenten wirklich gut anfühlt – bleibt auf der Aufgabe, arbeitet Tool-Ergebnisse sauber ab, kommt mit unsauberen Workflows klar. Hier hört Selbst-Hosting auf, ein Hacker-Setup zu sein, und wird zur Infrastruktur-Planung.
Stufe 3: GLM und Kimi K2 (das Extrem)
Riesige Open-Weight-Modelle, explizit für agentisches Engineering gebaut. Die Hardware ist brutal: Multi-GPU-Maschinen, je nach Setup 30 bis 40 Dollar pro Stunde. Im Dauerbetrieb landest du bei 20.000 bis 28.000 Dollar monatlich. Capability-mäßig fühlt sich das nicht mehr wie ein Kompromiss an, sondern wie ein echter Ersatz für ein Frontier-Modell. Für die allermeisten Agenturen schlicht zu teuer.
Die unbequeme Wahrheit
Du willst wissen, wo KI-Automatisierung in deinem Unternehmen sofort wirkt? Dieser Report zeigt dir konkrete Praxisbeispiele und Fallstudien von unseren Kunden im Bereich Marketing, Vertrieb, Onboarding und Kundenservice.
Hier kommt der Teil, den niemand gerne ausspricht: Solange OpenAI und Anthropic die Inferenzkosten über ihre Pro- und Max-Abos quersubventionieren, bekommst du für ein paar hundert Dollar im Monat einen Agenten, der dir beim Coden hilft, Probleme untersucht, recherchiert und Systeme überwacht. Das ist keine Ausgabe – das ist eine der höchsten ROI-Entscheidungen, die du gerade treffen kannst.
Wer jetzt mehrere tausend Dollar monatlich in eigene Hardware steckt, um dasselbe etwas schlechter zu bekommen, rechnet falsch. Aber: Das ist eine Subvention. Subventionen enden. Und Modelle verschwinden, wie Fable und Mythos gerade gezeigt haben.
Die richtige Haltung ist nicht "alles selbst hosten" und nicht "blind auf eine API setzen". Die richtige Haltung ist hybrid – und sie ist architekturgetrieben.
Ad-hoc-KI vs. Infrastruktur-KI
Genau hier trennt sich die Spreu vom Weizen:
Ad-hoc-KI bedeutet, du baust deine Delivery fest auf ein konkretes Modell. Du hardcodest "GPT" oder "Opus" in jeden Workflow. Funktioniert prima – bis der Anbieter den Preis verdreifacht, das Modell deprecatet oder eine Regierung es bannt. Dann baust du alles neu.
Infrastruktur-KI bedeutet, das Modell ist eine austauschbare Schicht in deiner Architektur. Deine Workflows, Prompts, Tool-Anbindungen und Kundendaten leben in einer Struktur, die das Modell nicht kennen muss. Wird ein Modell teuer oder verschwindet es, tauschst du eine Komponente. Du baust nichts neu.
Der Fable-Bann ist keine Randnotiz. Er ist die teuerste Werbung für Infrastruktur-Denken, die du dieses Jahr bekommst.
Fazit: Hybrid denken, klug handeln
Hier ist, was du konkret tun solltest:
Halte einen Fuß im Self-Hosting. Lern, wie diese Modelle funktionieren, verfolge die Hardware-Entwicklung, versteh die Trade-offs. Wir bewegen uns in diese Richtung – in zwei Jahren sieht die Rechnung anders aus.
Nutze für die Arbeit, die heute zählt, die besten gehosteten Modelle. Solange sie subventioniert sind, verschwende diese Phase nicht.
Setz Self-Hosting gezielt ein – da, wo Datenschutz, Kontrolle und wiederkehrende, eng umrissene Workflows es rechtfertigen. Nicht überall, sondern genau dort.
Bau deine Architektur so, dass das Modell austauschbar ist. Wer das hat, schläft ruhig – egal welcher Brief abends um 5:21 Uhr bei welchem Anbieter eintrifft.
Wir sind nah dran am souveränen, selbstgehosteten Agenten. Aber wir sind noch nicht da. Wer das ehrlich anerkennt und trotzdem architektonisch vorbaut, gewinnt in beiden Welten. Fang heute damit an – bevor dein wichtigstes Werkzeug morgen über Nacht verschwindet.